作为一个计算数学本科转型到统计来的普通博士生,在当前的研究生活当中深感自己目光老旧,一个体现就是一个方法的发展实际上在没那么长的时间就经过了快速的迭代,但是自己似乎还在使用一些其实很老派的模型或者方法。然而研究任务已经上了一条不太容易更改的轨道,为了学习更前沿和交叉的内容,在此以博客的形式进行输出。我将以“统计计算的现代旅程”作为专栏名,从现在开始进行定时的阅读和输出。
本专栏的宗旨是围绕统计学和计算数学,深入到一些相对“时新”的模型当中去(当然也有可能部分人觉得也挺老的),作为这两个专业背景的人,我的看法是:不能计算的统计不是好统计,也因此博客里面我们将会格外注重计算。繁杂的证明过程要么跳过,要么能折叠以便读者跳过。第一个主题是从变分推断到生成模型,我们将会从变分推断的起源开始,逐步开始到 VAE、SVGD、Normalizing flow、Neural ODE、DDPM 乃至 Schrödinger Bridge 等议题。
本专栏采用古法手写,或许 Agent 工具可以很快速的生成一份还不错的博客,但是手写是我思考的一份过程,也希望这份思考能帮到哪怕一个读者。
这一次我们将详细讨论变分推断,它是贝叶斯统计计算里面非常重要的一类工具,也非常符合计算数学的口味,因为它实际上就是一类优化方法。
变分推断的起源
变分是什么?—— 数学当中的变分法
变分推断无非拆成两个词:“变分”和“推断”。推断或许在统计里面经常出现,但是变分只怕是非数学专业的人都难以理解词义。这个实际上是一种历史上的原因。变分对应了数学上的变分法。我们简单来提及一下它的内容。我们知道在微积分当中,我们关注的一个问题是对函数求极值,例如对于函数 我们希望求得它的极小值或者极大值。为此我们使用导数,例如求 ,也就是一阶导数,并令其为 0 。但是假如说我们不再是对函数求极值,而是对泛函求极值呢?这里对泛函不熟悉的读者无需担心,因为我们下面并不必需其严格定义,读者可以暂且理解为“函数的函数”,也就是说,此时我们的目标不再是求一个最优点,而是一个最优函数。
严格的泛函定义
定义 1:泛函是一个由线性空间 映射到 标量域(例如 或者 )的映射。
一个例子是,熟悉概率论或者学过深度学习的读者可能知道一个概念是信息熵(交叉熵损失等概念就来源于信息熵),对于离散随机变量 ,其信息熵为
这实际上还是一个泛函,因为随机变量如果根据 Kolmogrov 公理体系就是一个函数。如果细心留意,我们其实早就和泛函打交道了。在学习微积分的时候,可以知道无论是导数,还是 Lagrange 乘子法,主要针对的对象都是常见的函数,但是对于泛函,以往的计算方式就乏力了。变分法在此时就有重要的作用。
变分法的起源问题是著名的最速降线问题 ,它的问题形式如下所示:
(最速降线问题)寻找一个最优的弧面曲线 ,满足如下的质点运动时间最小:
这实际上就是一个最小化泛函的问题,事实上我们要求的就是最优函数 。时至今日,变分法已有较大的发展,一个重要分枝就是本文将要讨论的变分推断。它是将变分法引入到统计学,尤其是贝叶斯统计推断的方法。
贝叶斯推断——计算的核心难点
贝叶斯方法的核心都是围绕贝叶斯公式,假设我们关心的参数是 ,它可以是一元或多元的未知参数,简单的例如人群的平均身高,复杂的例如机器学习和深度学习当中的模型参数(线性回归、高斯过程、MLP 等等)。贝叶斯方法要求我们给出参数的一个先验分布的密度函数 ,然后我们作为建模者知道 ,也就是似然函数 (likelihood),它实质上代表了我们的建模方式。当我们采集到数据后,说明我们已知了部分 的信息,我们需要转而求 ,也就是后验分布,这就是贝叶斯公式派上用场的时候:
后验分布是贝叶斯的核心,无论是点估计、还是模型预测,都离不开后验分布。但是它的计算并没有那么容易,我们可以看到分母是有一个积分的,而积分并不一定好求。
一个简单的例子就是:
可以看到这个先验函数乘上正态分布的密度函数是可积但是没有初等原函数,因此就无法得到一个令人满意的解析解。
对于这个推断问题,如果不能得到精确的解析解,那能否有近似的解析解?从这个想法出发,那也就是说我们在某种度量下,想找到一个和我们的后验分布密度最近的函数,这就转化为了一个寻找最优函数的问题。那和变分法不就是解决类似的问题吗?这就是变分法用在了贝叶斯推断,也就是变分推断 (Variational Inference)。
变分推断
度量的选取——KL散度
到这里我们可以说开始了正式的变分推断理论,刚刚我们提到 后验分布是我们所需要的,但是也是我们无法解析求出的,既然是这样,我们就用近似的方法,例如用一个 来代表近似分布(为简便起见,实则严谨写法应写为 ),第一步要做的事情就是明确我们所需的度量,对于两个分布之间的“距离”,在信息论当中
(KL 散度)KL 散度定义如下:
需要注意的是其不具有对称性。
那么,我们的目标就是从一个给定的分布族 当中,找到和 相距最近,也就是 KL 散度最小的分布 。这个想法本身可以脱离推断的语境来说明,此时它称为变分近似 (variational approximation),例如用一元正态分布近似指数分布等:
例 1:使用变分近似方法 近似 ,其中 为已知参数。
解答
这个问题会因为 KL 散度不具有对称性而需要选择方向,我们设 是指数分布对应的 PDF ,而 是正态分布的 PDF ,我们在这里用变分近似方法时,应当考虑的 KL 散度是:
此时我们进行简单的展开,可以知道
那么我们仅需关心后者,也就是 的计算,考虑到
于是考虑指数分布的期望的性质,有 ,从而我们最小化 KL 散度等价于最小化如下的函数:
我们对其求导可以得到
如果这些偏导数为 ,可以解得 ,也就是说变分近似指数分布的正态分布确定参数的方式就是矩匹配:让均值和方差与对应的指数分布相同即可。
当然,我们还是得回到推断的具体语境下进一步推导。实质上变分推断所需要解的原始问题如下:
这个问题有一个致命的点在于,我们本身就是不知道 才会选择这种迂回的方式来求解,但是这里的 KL 散度却需要我们提供它,这就出现了矛盾。那么我们又如何进一步求解?
变分下界
对于一般的变分推断问题,我们接下来的操作相对通用,对于 KL 散度我们将其拆分:
这个推导的主要作用就是让我们发现了最终的结果已经是可以计算的形式,原因在于 作为联合分布,可以通过 来求解,而 尽管是一个复杂的积分,但对于优化而言,它是和 无关的常数,于是可以不 care 它的具体取值是什么。 具有一个专门的名称为证据 (evidence),我们接下来将上式推导为:
而 KL 散度具有一个重要性质是非负性,这就表明
这就得到了证据下界:
(定义:证据下界)我们将如下的项合并起来称为证据下界 (evidence lower bound):
也被称为变分下界。
所以我们可以写为一个恒等式:
然后就知道,ELBO 就是证据的下界,所以才叫证据下界。由于 和参数无关,可以说明证据下界和 KL 散度实际上是一个此消彼长的关系:最小化 KL 散度实际上就是最大化 ELBO,也因此问题变成了一个最大化问题:
这个最大化问题通常情况下是可解的,也因此变分推断事实上主要关心的就是 ELBO 的最大化。
KL 方向的影响
KL 散度的方向事实上会影响我们对于变分近似的效果,原因在于两个方向下 KL 散度的意义是不同的:
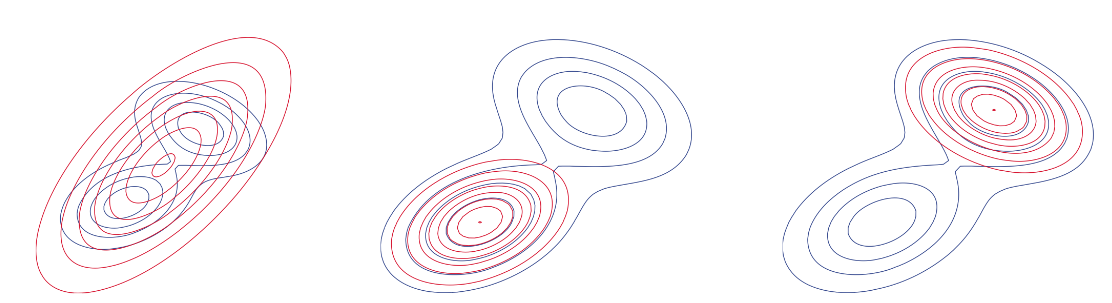
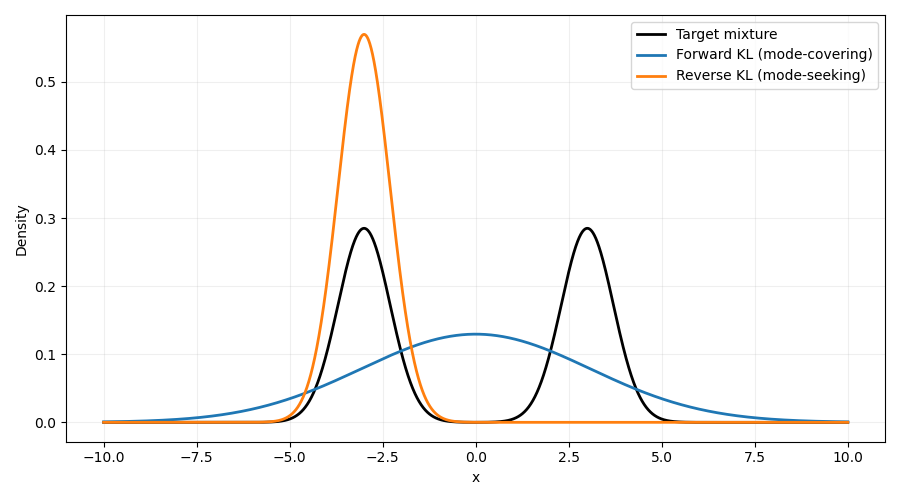
- 最小化反向 KL 散度即最小化 ,可以将其理解为在 分布下求期望的操作,那么此时如果 在 取值较小的部分集中,则会受到更大的惩罚,因此如果 是多峰的,那么 更有可能只集中的其中的一个;
- 最小化正向 KL 散度即最小化 ,那么此时是 分布下的期望,此时的优化行为更像是让 符合整体的状态,例如多峰函数下 就也会趋向于整体上“都不得罪”,也就是不集中在特定的一个峰。
Stanford CS330 这个课程在变分推断一节中 对此的描述是前者称为 mode-seeking ,后者称为 mode-covering ,我觉得相对更形象,因为这其实就是集中在一个众数和覆盖多个众数之间的区别。
我们用一个数值例子来进行说明,我们考虑一个双峰的正态混合分布:
然后我们仅仅允许使用单个一元正态分布 来逼近,度量分别使用正向 KL 散度 (Forward KL) 以及反向 KL 散度 (Reverse KL) 来解决。我们用如下 Python 代码来求解:
import numpy as np
import matplotlib.pyplot as plt
from scipy.stats import norm
from scipy.optimize import minimize
from scipy.special import logsumexp

# Target: bimodal Gaussian mixture
x = np.linspace(-10, 10, 4000)

def log_p(x):
    a = norm.logpdf(x, -3, 0.7)
    b = norm.logpdf(x,  3, 0.7)
    return logsumexp([a, b], axis=0) - np.log(2)

p = np.exp(log_p(x))

# Forward KL: moment matching
mu_f = 0
sigma_f = np.sqrt(3**2 + 0.7**2)

# Reverse KL: numerical minimization
def reverse_kl(params):
    mu, log_sigma = params
    sigma = np.exp(log_sigma)
    log_q = norm.logpdf(x, mu, sigma)
    q = np.exp(log_q)
    return np.trapezoid(q * (log_q - log_p(x)), x)

# Multiple starts to account for local minima
results = [
    minimize(reverse_kl, [m, np.log(0.7)],
             method="L-BFGS-B",
             bounds=[(-8, 8), (-2, 2)])
    for m in [-3, 0, 3]
]
best = min(results, key=lambda r: r.fun)
mu_r, sigma_r = best.x[0], np.exp(best.x[1])

# Plot
plt.figure(figsize=(9, 5))
plt.plot(x, p, label="Target mixture", color="black", lw=2)
plt.plot(x, norm.pdf(x, mu_f, sigma_f),
         label="Forward KL (mode-covering)", lw=2)
plt.plot(x, norm.pdf(x, mu_r, sigma_r),
         label="Reverse KL (mode-seeking)", lw=2)

plt.xlabel("x")
plt.ylabel("Density")
plt.legend()
plt.grid(alpha=0.2)
plt.tight_layout()
plt.show()

print("Forward:", mu_f, sigma_f)
print("Reverse:", mu_r, sigma_r)
没有别的度量了吗?
除了 KL 散度,事实上还有其他的概率度量,有感兴趣的读者可以考虑参阅 Statistical distance 的 Wikipedia 页面,里面包含了更多包括 Rényi divergence 在内的距离度量,基本都是为了解决 KL 散度非对称性以及容易发散到无穷大的问题。
下一步……
我们将在之后深入挖掘变分推断的议题,我们还有这样的一些具体问题其实并为说明:
- 在对目标分布缺乏理解的情况下,如何选择变分分布族 ?
- ELBO 本身还是一个积分,我们如何保证对它的优化实际上确实更加方便呢?
此外,我们不会忘记之后的目标,会更多地涉及到一些更难的内容。
2 References
Chelsea Finn. (2023). CS 330 Deep Multi-Task and Meta Learning. https://cs330.stanford.edu/
老大中. (2015). 变分法基础 (第三版 ed.). 国防工业出版社.
留言