身为数学系的学生,经过四年的本科学制学习,发现自己其实数学这个老本行其实还是学的不够,究其原因在于虽然一般数学系的《高等代数》课程包含的内容比一般的线性代数课程多出了一些相对高深点的内容,包括 λ \lambda
矩阵微分是数学分析当中多变量微分的推广,在数学分析当中我们学过了多变量微积分,涉及到梯度等概念。在后续的研究当中,包括矩阵优化在内的主题都会包含矩阵微分,这也是为什么我开始进行这样一个系列的学习。
On this page
Loading…
符号说明
对于变量,小写粗体为实列向量变量,例如 𝒙 = ( x 1 , ⋯ , x m ) ⊤ ∈ ℝ m \boldsymbol{x} = (x_1, \cdots, x_m)^\top \in \mathbb{R}^{m}
对于变量,大写粗体为实矩阵变量,例如 𝑿 = ( 𝒙 1 , ⋯ , 𝒙 n ) ∈ ℝ m × n \boldsymbol{X} = (\boldsymbol{x}_1, \cdots, \boldsymbol{x}_n) \in \mathbb{R}^{m\times n}
对于函数,小写普通字母是正常的实值函数,小写加粗字母表示输出为列向量的向量函数,大写加粗字母表示输出为实矩阵的矩阵函数(当然,输出是实矩阵的映射其实更应该叫做泛函,但是在这里还是用函数),例如 f , 𝒇 , 𝑭 f, \boldsymbol{f}, \boldsymbol{F}
对于矩阵:
𝑿 = ( x 11 x 12 ⋯ x 1 n x 21 x 22 ⋯ x 2 n ⋮ ⋮ ⋱ ⋮ x m 1 x m 2 ⋯ x m n ) \boldsymbol{X} =
\begin{pmatrix}
x_{11} & x_{12} & \cdots & x_{1n} \\
x_{21} & x_{22} & \cdots & x_{2n} \\
\vdots & \vdots & \ddots & \vdots \\
x_{m1} & x_{m2} & \cdots & x_{mn} \\
\end{pmatrix} 考虑向量化的运算 vec ( 𝑿 ) \mathrm{vec}(\boldsymbol{X})
vec ( 𝑿 ) = ( x 11 , x 21 , ⋯ , x m 1 , x 12 , x 22 , ⋯ , x 1 n , x 2 n , ⋯ , x m n ) ⊤ \mathrm{vec}(\boldsymbol{X}) = (x_{11}, x_{21}, \cdots, x_{m1}, x_{12}, x_{22},\cdots, x_{1n}, x_{2n}, \cdots, x_{mn})^\top
Jacobian 矩阵和梯度矩阵
Jacobian 矩阵
实值函数的 Jacobian 矩阵
在这里我们主要讨论实值函数和矩阵函数的微分,向量函数微分可以视为矩阵函数微分的一个特例。
实值函数其实就是我们熟悉的多变量函数,这种函数的微分在数学分析当中已经有详细说明,如果实值函数的输入是向量,那么此时的 Jacobian 矩阵就是梯度:
∂ f ( 𝒙 ) ∂ 𝒙 ⊤ = ( ∂ f ( 𝒙 ) ∂ x 1 , ⋯ , ∂ f ( 𝒙 ) ∂ x m ) \dfrac{\partial f(\boldsymbol{x})}{\partial \boldsymbol{x}^{\top}} = \left(\dfrac{\partial f(\boldsymbol{x})}{\partial x_1}, \cdots, \dfrac{\partial f(\boldsymbol{x})}{\partial x_m}\right) 如果输入是矩阵,那么此时的 Jacobian 矩阵定义也相对比较简单:
矩阵函数的 Jacobian 矩阵
现在考虑实值矩阵函数 𝑭 ( 𝑿 ) = ( f k l ) k = 1 , l = 1 p , q ∈ ℝ p × q \boldsymbol{F}(\boldsymbol{X}) = (f_{kl})_{k=1,l=1}^{p,q} \in \mathbb{R}^{p\times q}
∂ 𝑭 ( 𝑿 ) ∂ 𝑿 ⊤ ≔ ∂ vec ( 𝑭 ( 𝑿 ) ) ∂ [ vec ( 𝑿 ) ] ⊤ ∈ ℝ p q × m n \dfrac{\partial \boldsymbol{F}(\boldsymbol{X})}{\partial \boldsymbol{X}^\top} \coloneqq
\dfrac{\partial \mathrm{vec}(\boldsymbol{F}(\boldsymbol{X}))}{\partial [\mathrm{vec}(\boldsymbol{X})]^\top} \in \mathbb{R}^{pq\times mn} 其具体表达式为:
这种定义是相对比较合理的,在不同教材上实际上会出现很多种定义,有的定义是明显不合适的。
不合适 的矩阵函数微分定义一些矩阵函数的 Jacobian 矩阵的定义是很糟糕的,例如一个看似很合理的定义:
∂ 𝑭 ( 𝑿 ) ∂ 𝑿 ⊤ = ( ∂ f 11 ( 𝑿 ) ∂ 𝑿 ⊤ ⋯ ∂ f 1 q ( 𝑿 ) ∂ 𝑿 ⊤ ⋮ ⋱ ⋮ ∂ f p 1 ( 𝑿 ) ∂ 𝑿 ⊤ ⋯ ∂ f p q ( 𝑿 ) ∂ 𝑿 ⊤ ) \dfrac{\partial \boldsymbol{F}(\boldsymbol{X})}{\partial \boldsymbol{X}^\top} =
\begin{pmatrix}
\dfrac{\partial f_{11}(\boldsymbol{X})}{\partial \boldsymbol{X}^\top} & \cdots & \dfrac{\partial f_{1q}(\boldsymbol{X})}{\partial \boldsymbol{X}^\top} \\
\vdots & \ddots & \vdots \\
\dfrac{\partial f_{p1}(\boldsymbol{X})}{\partial \boldsymbol{X}^\top} & \cdots & \dfrac{\partial f_{pq}(\boldsymbol{X})}{\partial \boldsymbol{X}^\top} \\
\end{pmatrix} 它的不合理之处在于对于一些基本的矩阵函数,它的 Jacobian 矩阵都是非常不符合逻辑的,例如 𝑭 ( 𝑿 ) = 𝑿 \boldsymbol{F}(\boldsymbol{X}) = \boldsymbol{X} vec ( 𝑰 m ) ⊤ vec ( 𝑰 n ) \mathrm{vec}(\boldsymbol{I}_m)^\top \mathrm{vec}(\boldsymbol{I}_n)
梯度矩阵实际上就是 Jacobian 矩阵的转置 。在这里我们主要介绍梯度算子 ∇ \nabla 列向量偏导算子 ,因为一般它对一个实值函数作用后得到的是一个列向量:
∇ 𝒙 = ( ∂ ∂ x 1 , ⋯ , ∂ ∂ x m ) ⊤ \nabla_{\boldsymbol{x}} = \Bigl( \dfrac{\partial}{\partial x_1}, \cdots, \dfrac{\partial}{\partial x_m} \Bigr)^\top 如果是行向量偏导算子,其实就是转置一下。对于实矩阵函数 𝑭 ( 𝑿 ) ∈ ℝ p × q \bm{F}(\bm{X}) \in \mathbb{R}^{p\times q} f f 梯度流 (gradient flow).
例题 1:计算实值函数 f ( 𝒙 ) = 𝒙 ⊤ 𝑨 𝒙 f(\bm{x}) = \bm{x}^\top \bm{A} \bm{x} 这就是最常见的二次型函数 Jacobian 矩阵,由于 𝒙 ⊤ 𝑨 𝒙 = ∑ k = 1 n ∑ l = 1 n a k l x k x l \bm{x}^\top \bm{A} \bm{x} = \sum_{k=1}^n \sum_{l=1}^n a_{kl} x_k x_l i i
∂ ∂ x i ∑ k = 1 n ∑ l = 1 n a k l x k x l = ∑ k = 1 n ( a k i + a i k ) x k \dfrac{\partial}{\partial x_i} \sum_{k=1}^n \sum_{l=1}^n a_{kl} x_k x_l = \sum_{k=1}^n (a_{ki}+ a_{ik}) x_k 因此可写出其 Jacobian 矩阵 𝒙 ⊤ ( 𝑨 + 𝑨 ⊤ ) \bm{x}^\top (\bm{A} + \bm{A}^\top)
□ \square
例题 2:计算实值函数 f ( 𝑿 ) = 𝒂 ⊤ 𝑿 𝑿 ⊤ 𝒃 f(\bm{X}) = \bm{a}^\top \bm{X}\bm{X}^\top \bm{b} 𝑿 ∈ ℝ m × n , 𝒂 , 𝒃 ∈ ℝ n × 1 \bm{X}\in \mathbb{R}^{m\times n}, \bm{a}, \bm{b} \in \mathbb{R}^{n\times 1} 根据矩阵输入实值函数的 Jacobian 矩阵定义 ,可以计算 Jacobian 矩阵第 i i j j
∂ f ∂ x i j = ∑ k = 1 m ∑ l = 1 m ∑ p = 1 n ∂ a k x k p x l p b l ∂ x j i = ∑ i = 1 m ∑ l = 1 m ∑ j = 1 n a j x l i b l + ∑ k = 1 m ∑ i = 1 m ∑ j = 1 n a k x k i b j \dfrac{\partial f}{\partial x_{ij}} =
\sum_{k=1}^m \sum_{l=1}^{m}\sum_{p=1}^n \dfrac{\partial a_k x_{kp} x_{lp} b_l}{\partial x_{ji}} = \sum_{i=1}^m \sum_{l=1}^m \sum_{j=1}^n a_{j} x_{li} b_l + \sum_{k=1}^m \sum_{i=1}^m \sum_{j=1}^n a_k x_{ki} b_j 因此 Jacobian 矩阵和梯度矩阵分别为
𝑿 ⊤ ( 𝒃 𝒂 ⊤ + 𝒂 𝒃 ⊤ ) \bm{X}^\top (\bm{b}\bm{a}^\top + \bm{a}\bm{b}^\top) □ \square
例题 3:计算实值函数 𝑭 ( 𝑿 ) = 𝑨 𝑿 𝑩 \bm{F}(\bm{X}) = \bm{A X B} 𝑨 ∈ ℝ p × m , 𝑿 ∈ ℝ m × n , 𝑩 ∈ ℝ n × q \bm{A} \in \mathbb{R}^{p\times m}, \bm{X} \in \mathbb{R}^{m\times n}, \bm{B} \in \mathbb{R}^{n\times q} 先考虑表示出矩阵函数的各个分量:
f i j ( 𝑿 ) = ∑ k = 1 n ( 𝒂 i ⊤ 𝒙 k ) b k j = ∑ k = 1 n ( ∑ l = 1 m a i l x l k ) b k j f_{ij}(\bm{X}) = \sum_{k=1}^{n} (\bm{a}_i^\top \bm{x}_k) b_{kj} = \sum_{k=1}^n \Bigl( \sum_{l=1}^m a_{il} x_{lk}\Bigr) b_{kj} 那么此时对于 矩阵函数 Jacobian 矩阵的定义 ,有
∂ f i j ∂ [ vec ( 𝑿 ) ] ⊤ = ( a i 1 b 1 j , a i 2 b 1 j , ⋯ , a i m b 1 j , a i 1 b 2 j , ⋯ , a i m b 2 j , ⋯ , a i m b n j ) \dfrac{\partial f_{ij}}{\partial [\mathrm{vec}(\bm{X})]^\top}
=
(a_{i1}b_{1j}, a_{i2}b_{1j}, \cdots, a_{im}b_{1j}, a_{i1}b_{2j} , \cdots, a_{im}b_{2j}, \cdots, a_{im}b_{nj}) 最后通过向量化拼接即可,在这里为了简便起见不给出整个矩阵的公式。当然如果用 Kronecker 积的形式写就是 𝑩 ⊤ ⊗ 𝑨 \bm{B}^\top \otimes \bm{A}
□ \square
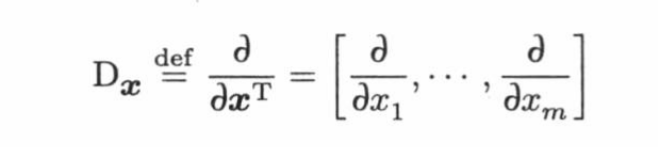
留言